企业知识 · 平台产品
RAG 知识增强问答平台
从复杂文档入库到可追溯问答和批量评测的完整产品闭环
能力概览
独立设计并实现企业知识问答平台,把知识治理、检索、引用、权限和评测做成可观测闭环。
知识产品
- 问题与知识范围独立完成问题定义、知识入库与引用闭环,明确复杂文档到可追溯问答的产品边界。
- 权限与引用独立设计权限、引用和知识治理机制,使答案可追溯、可运营,而非只展示生成答案。
- 端到端产品闭环独立完成端到端产品闭环,把入库、检索、评测、运营和验收串成同一工作台。
检索与评测
- 混合检索架构独立设计并实现解析、BM25、RRF、Rerank 与知识图谱等混合检索链路。
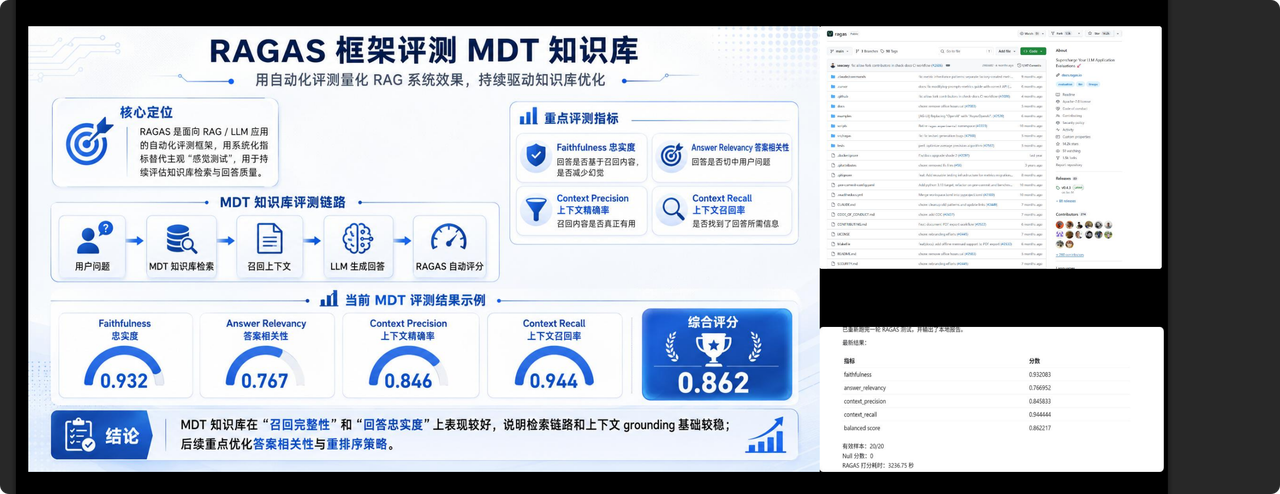
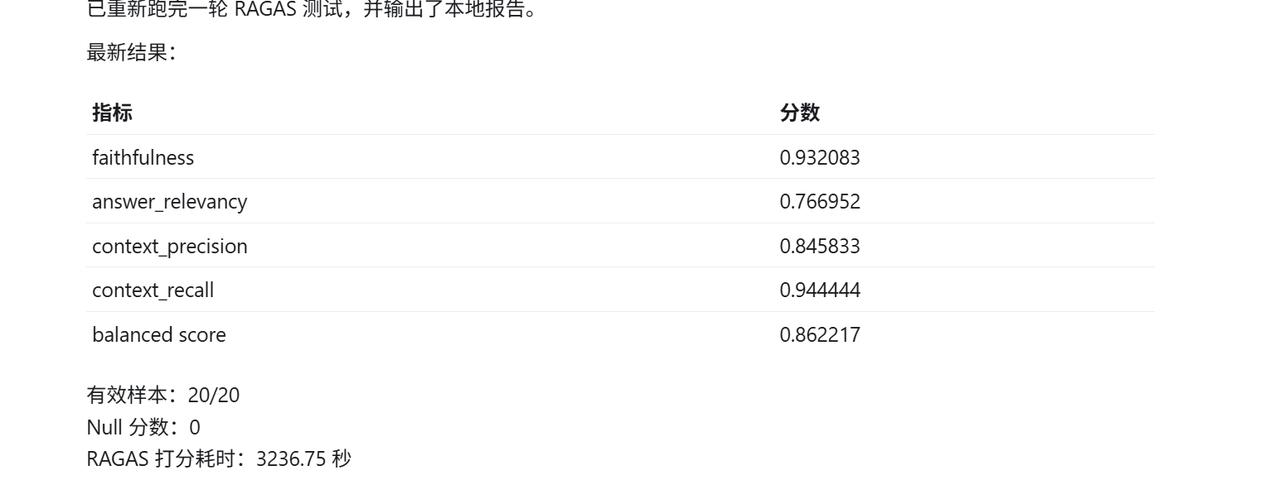
- RAGAS 评测独立建立效果指标、RAGAS 与 Bad Case,持续迭代长文档召回、引用质量与检索策略。
- 平台事实边界召回、请求量与场景覆盖仅用于说明样本、时间窗口和平台范围,不外推为个人处理量。
Product architecture / 产品架构
用可观测流水线拆解答案质量
把摄入质量、检索质量和评测质量拆开管理,再用统一的运营闭环持续优化。- 01
摄入与索引
多格式文档经解析、清洗与分块后,分别写入向量、关键词和可选图谱索引。
- 02
混合检索与重排
查询并行获得向量、BM25 与图谱候选,经 RRF、Reranker 与上下文压缩形成可引用答案。
- 03
评测与迭代
Golden Dataset、RAGAS、阶段耗时与 Bad Case 共同驱动参数、策略和知识库运营迭代。
边界说明该架构对应本人独立设计并实现的知识入库、检索、引用、评测与运营闭环;底层模型、Embedding、Rerank 和向量数据库采用外部模型或基础组件能力。
背景与问题
企业知识分散在 PDF、Word、PPT、Excel 与扫描件中,纯向量检索在专业术语、长文档和实体关系上召回不稳定;答案无法追溯、知识更新成本高,导致知识问答容易停留在演示阶段。
我的角色
作为 AI 项目经理,独立完成问题定义、产品架构、知识入库、混合检索、权限、引用、RAGAS、Bad Case、Roadmap 与验收闭环;底层模型、Embedding、Rerank 和向量数据库采用外部模型或基础组件,我不将这些底层能力表述为个人原创。
约束与取舍
- 纯向量、BM25 还是混合检索:纯向量更擅长语义相似,但专业实体和精确词组容易漏召回;BM25 对实体更稳定,却难覆盖同义表达。最终选择双路召回与 RRF 融合,代价是链路与调参复杂度上升。
- 所有结果都 Rerank 还是按场景控制:统一 Rerank 便于保证排序质量,但增加模型成本和响应时延。最终把候选数量、Rerank 和图谱增强做成知识库级策略,允许业务按准确性与时延取舍。
- 依赖人工体感还是建立评测集:快速人工试答适合 POC,却不能稳定回归。最终引入 Golden Dataset、RAGAS 和 Bad Case 运营,接受持续维护数据集的成本。
- 验证方式:分别观察检索召回、引用有效性、阶段耗时与业务接入,而不是只用最终回答的主观“像不像”判断效果。
产品方案
设计文档解析、OCR 清洗、语义分块、Embedding、向量与 BM25 双路召回、RRF 融合、Rerank、知识图谱增强、答案引用和 RAGAS 评测链路;补齐三级 API Key、按知识库开关策略、阶段耗时与 Bad Case 运营能力。
结果与证据
- 技术结果:长文档召回率较基线相对提升约 40%,并形成混合检索、引用和批量评测闭环。
- 平台结果:平台日均请求 12,000+,接入 10+ 企业业务场景;该请求量用于说明平台负载,不表示由我逐条处理。
- 产品结果:文档接入、权限、阶段耗时、RAGAS 与 Bad Case 进入同一运营工作台;未公开测试环境的时延数字不用于跨系统比较。
局限与下一步
现有评测更偏长文档和已接入场景,对表格、扫描件、频繁更新知识和跨库权限的覆盖仍不足;知识纠错也依赖运营人员主动发现。下一步应扩展分类型 Golden Dataset,并追踪知识更新时间、无答案率、转人工和人工修订成本。
PROJECT SHOWCASE / 项目展示
从能力模块,到可交付的产品界面。
以下截图按产品链路整理,已移除内部地址、密钥、二维码与环境信息;点击图片可查看原图。
知识库与 RAGAS 评测
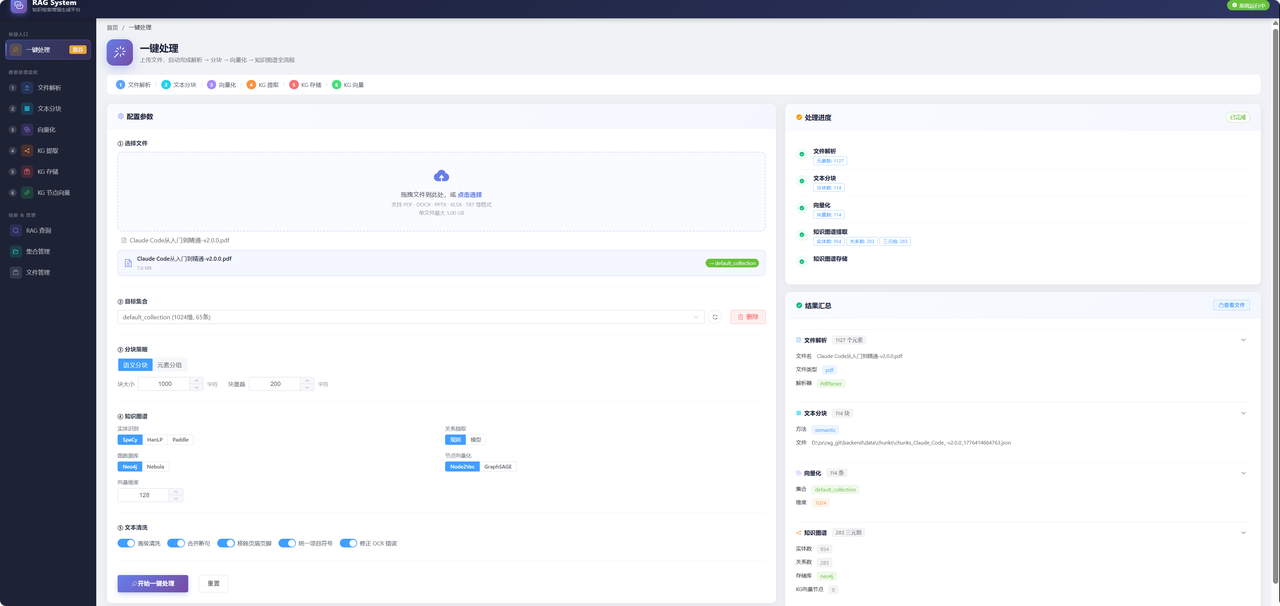
从文档接入、切分与向量化,到评测说明和单轮本地指标输出,呈现知识链路的配置与验证入口。